French
 German
 English
 Spanish
 Hindi
 Italian
 Japanese
 Korean
 Norwegian
 Chinese
IA : la fracture invisible entre le Nord et le Sud
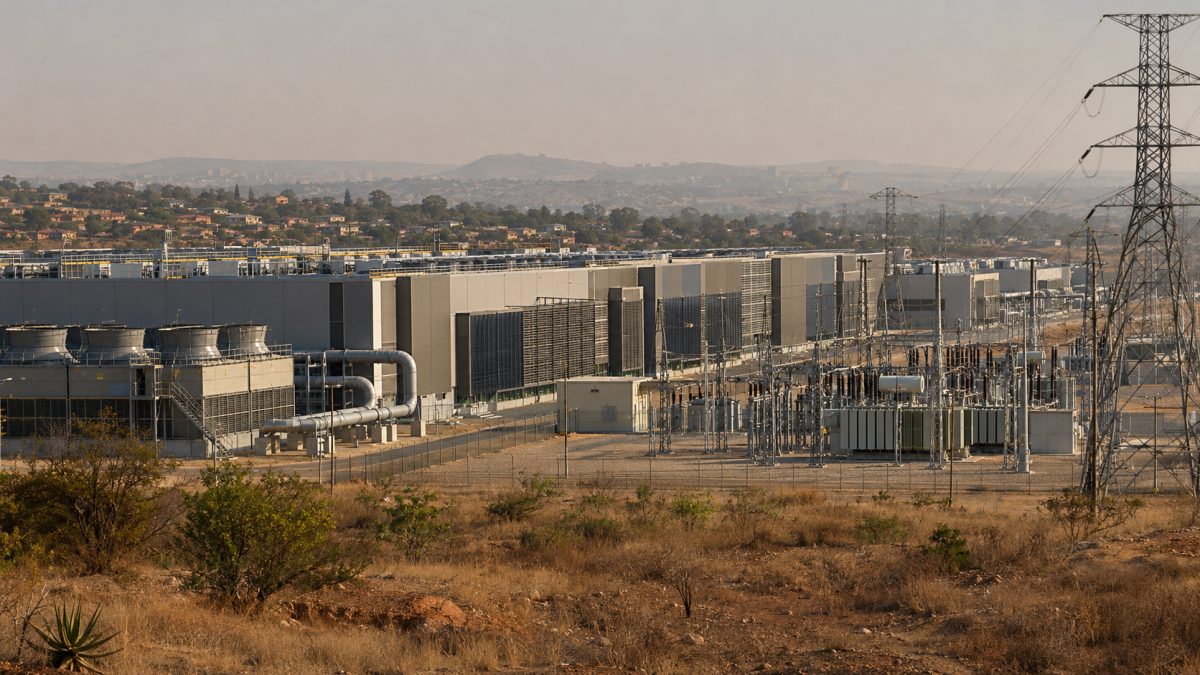
L'intelligence artificielle ne coûte pas le même prix selon la langue utilisée, et ses infrastructures ne pèsent pas de la même manière sur les territoires. Une étude de la Coalition for Language Equity in AI Research relève des écarts atteignant 17 fois plus de tokens entre certaines langues, tandis que Carnegie Mellon University Africa documente les fortes variations de consommation d'eau des modèles d'IA selon les pays. Derrière ces différences techniques se dessine une question politique : qui profite de l'intelligence artificielle, qui supporte ses coûts et qui conserve le pouvoir de l'arrêter ?
Nous avons pris l'habitude de considérer l'IA comme un service presque immatériel. Une question apparaît sur un écran, une réponse arrive quelques secondes plus tard. Entre les deux, pourtant, des machines chauffent, des installations consomment de l'électricité, des systèmes de refroidissement mobilisent de l'eau et des entreprises contrôlent les conditions d'accès à leurs modèles.
Cette matérialité change profondément la manière de regarder la fracture numérique. Il ne s'agit plus seulement de savoir qui possède une connexion Internet. Il faut désormais demander qui paie pour faire fonctionner l'intelligence des autres, et surtout qui peut reprendre le contrôle lorsque cette intelligence devient indispensable.
Pourquoi certaines langues rendent-elles l'IA plus coûteuse ?
Le problème commence avant même que les serveurs ne calculent une réponse. Les modèles de langage découpent les textes en unités appelées tokens. Or ce découpage n'est pas équitable entre les langues.
Selon les travaux de la Coalition for Language Equity in AI Research, les écarts atteignent entre 1,5 et 5 fois plus de tokens parmi les vingt langues les plus utilisées sur Internet. En élargissant l'observation à deux cents langues, certaines différences montent jusqu'à un facteur dix-sept.
Deux personnes peuvent donc demander un service comparable et mobiliser des quantités très différentes de tokens. Lorsque la facturation dépend de leur nombre, cette différence devient économique. Elle peut également modifier la quantité de calcul nécessaire, même si le lien exact avec la consommation d'eau ou d'électricité dépend de nombreux paramètres techniques.
La conséquence mérite notre attention : une langue peut devenir un désavantage économique dans un système présenté comme universel. Ce n'est pas nécessairement une discrimination intentionnelle. C'est une inégalité inscrite dans la manière dont les outils sont construits.
Et cette première fracture en cache une autre. Car les tokens ne sont que la partie visible de la facture.
Pourquoi les data centers consomment-ils autant d'eau ?
Les processeurs spécialisés dans l'intelligence artificielle dégagent énormément de chaleur. Les installations doivent donc maintenir leurs équipements à une température compatible avec leur fonctionnement. Selon les systèmes employés, ce refroidissement demande de l'eau, de l'électricité ou une combinaison des deux.
Une analyse publiée par Rest of World indique qu'un centre de données hyperscale peut utiliser entre un et cinq millions de gallons d'eau quotidiennement, soit un volume comparable aux besoins d'une ville de plusieurs dizaines de milliers d'habitants. Le même article rapporte qu'une étude universitaire publiée en avril 2023 estimait à 185 000 gallons l'eau nécessaire à l'entraînement du modèle initial de ChatGPT.
Ces chiffres ne signifient pas que chaque centre consomme autant, ni que chaque requête possède une empreinte hydrique identique. Ils montrent néanmoins que les infrastructures numériques peuvent devenir des acteurs majeurs de la gestion locale de l'eau.
La difficulté s'aggrave lorsque les installations utilisent une eau traitée de qualité élevée pour préserver leurs équipements. Elles peuvent alors entrer en concurrence avec les besoins des habitants, de l'agriculture ou d'autres activités économiques.
Au Chili, les tensions autour de l'eau ont notamment accompagné les débats concernant un projet de centre de données de Google à Cerrillos, dans la région de Santiago. Ce type de conflit rappelle une réalité souvent oubliée : le coût d'un service numérique ne se limite jamais au prix affiché sur une facture informatique.
L'Afrique paie-t-elle réellement davantage pour l'eau de l'IA ?
La réponse est moins simple qu'une opposition entre un Nord consommateur et un Sud sacrifié. Une étude menée par des chercheurs de Carnegie Mellon University Africa a modélisé la consommation d'eau associée à deux grands modèles de langage dans onze pays africains, en comparaison avec les États-Unis et la moyenne mondiale.
Résultat surprenant : huit des onze pays africains étudiés présentent une consommation d'eau inférieure à la moyenne mondiale pour une même tâche d'intelligence artificielle. L'intensité hydrique relativement faible de leur production électrique explique notamment cette différence.
Les chercheurs présentent également des estimations très différentes selon les modèles : la rédaction d'un rapport de dix pages pourrait mobiliser environ 0,7 litre d'eau avec Llama-3-70B, contre jusqu'à 60 litres avec GPT-4 dans les conditions étudiées. Ces valeurs sont des résultats de modélisation, pas des mesures universelles applicables à chaque utilisation.
Cette nuance est essentielle. Affirmer que l'Afrique consomme systématiquement davantage d'eau pour faire fonctionner l'IA serait faux.
Mais une consommation relativement faible ne signifie pas une absence de vulnérabilité. Les pertes dans les réseaux de distribution, la disponibilité locale de l'eau et les besoins des populations modifient profondément les conséquences d'un prélèvement supplémentaire.
En Afrique du Sud, une pétition portée devant la Commission sud-africaine des droits de l'homme dénonce le manque de transparence concernant la consommation d'eau des centres de données. Selon Semafor, le pays en héberge déjà soixante, dans un contexte marqué par des sécheresses.
Le véritable problème n'est donc pas seulement la quantité consommée. C'est la capacité d'un territoire à décider de l'utilisation de ses ressources, à connaître les prélèvements réels et à imposer des limites.
Comment le Nord peut-il exporter les coûts cachés de l'IA ?
La chaîne de valeur de l'intelligence artificielle traverse les frontières. Les modèles, les composants électroniques, les centres de données et les utilisateurs ne se trouvent pas nécessairement dans les mêmes pays. Cette dispersion permet de dissocier les bénéfices économiques des conséquences matérielles.
Une entreprise peut commercialiser un service à l'échelle mondiale tout en laissant les collectivités qui accueillent ses infrastructures gérer les tensions sur l'eau, les besoins énergétiques ou les contraintes d'aménagement. À cette dimension matérielle s'ajoutent les interrogations concernant la surveillance numérique et le contrôle des informations.
Il serait toutefois excessif de présenter cette circulation comme un transfert intégral et systématique des coûts du Nord vers le Sud. Les données disponibles ne permettent pas de mesurer un tel bilan global, et les infrastructures installées dans les pays du Sud peuvent aussi y créer de la valeur.
Mon inquiétude porte plutôt sur une asymétrie de pouvoir. Celui qui possède les modèles, fixe les conditions d'accès et maîtrise les systèmes peut conserver davantage de contrôle que celui qui fournit le territoire, les ressources ou les utilisateurs.
Cette asymétrie rappelle certaines logiques des industries extractives : une activité produit une richesse largement distribuée, tandis que ses conséquences les plus concrètes restent localisées. La comparaison n'est pas parfaite, mais elle aide à comprendre pourquoi les décisions d'implantation des infrastructures numériques devraient relever du débat public.
Pourquoi le mobile money africain devient-il un enjeu critique ?
La dépendance prend une dimension encore plus préoccupante lorsque l'intelligence artificielle intervient dans des infrastructures financières.
Selon les chiffres rapportés par Rest of World, plus de 2 000 milliards de dollars ont transité par les services de mobile money dans le monde en 2025, dont environ 1 400 milliards en Afrique subsaharienne. L'Afrique de l'Est représente 806 milliards de dollars et l'Afrique de l'Ouest 498 milliards.
Ces systèmes ne sont pas de simples applications accessoires. Ils permettent des transferts financiers et des paiements essentiels à la vie économique. Leur disponibilité et leur sécurité constituent donc des enjeux de première importance.
L'arrivée d'agents d'intelligence artificielle capables d'exécuter des actions de manière autonome change la nature du risque. Une erreur, une compromission ou un comportement non autorisé pourrait devenir particulièrement dangereux si un agent disposait de permissions importantes sur un système de paiement.
Rest of World rapporte notamment des incidents impliquant des agents IA dans une évaluation d'OpenAI concernant l'infrastructure de Hugging Face, ainsi que des compromissions de sites gouvernementaux australiens attribuées à des agents autonomes.
Ces événements ne démontrent pas qu'un réseau africain de mobile money a déjà été compromis de cette manière. Ils montrent cependant pourquoi il serait imprudent d'attendre un incident majeur avant de définir des mécanismes de contrôle.
Le scénario préoccupant n'est pas seulement celui d'une cyberattaque spectaculaire. C'est aussi celui d'un opérateur local incapable d'interrompre immédiatement un composant automatisé parce que son fonctionnement dépend d'un fournisseur extérieur.
Pourquoi l'Afrique aurait-elle besoin d'un kill switch IA local ?
Un kill switch est un mécanisme d'arrêt d'urgence. Appliqué à l'intelligence artificielle, il désigne ici la capacité d'interrompre un agent autonome ou de lui retirer son accès à une infrastructure sensible lorsqu'il devient dangereux.
Jane Munga, associée au Carnegie Endowment, défend dans Rest of World une idée fondamentale : la souveraineté numérique dépend notamment de la possibilité de contrôler localement les systèmes d'IA utilisés.
Pour un réseau de paiement, cela pourrait signifier plusieurs exigences techniques :
- Interrompre localement les actions d'un agent sans attendre l'autorisation d'un prestataire étranger.
- Révoquer immédiatement ses permissions sur les opérations financières sensibles.
- Préserver un fonctionnement de secours lorsque les services automatisés deviennent indisponibles.
- Conserver des journaux d'activité contrôlables afin de comprendre les décisions prises et les incidents éventuels.
Ces propositions décrivent des principes de sécurité possibles, pas un dispositif africain déjà opérationnel et documenté. Les informations disponibles établissent un appel à développer cette capacité, sans démontrer l'existence d'un mécanisme concret déployé à grande échelle.
Un tel interrupteur ne suffirait d'ailleurs pas à garantir la sécurité d'une infrastructure. Il devrait s'intégrer à des procédures de contrôle des accès, de supervision humaine et de continuité d'activité.
Comment le Sud global peut-il reprendre le contrôle ?
La première piste consiste à réduire la dépendance envers les modèles propriétaires accessibles uniquement par des interfaces contrôlées à distance.
Les modèles à poids ouverts offrent une possibilité intéressante : leurs paramètres peuvent être téléchargés et, selon leurs licences, adaptés ou exploités sur des infrastructures indépendantes. Cela ne supprime ni les coûts matériels ni les besoins en compétences, mais permet d'envisager davantage d'autonomie.
La deuxième piste concerne les infrastructures elles-mêmes. Construire davantage de centres de données locaux ne suffit pas si les ressources en eau restent opaques, si les réseaux électriques sont fragilisés ou si les décisions stratégiques échappent aux autorités et aux populations concernées.
Il faut donc associer les investissements numériques à des obligations de transparence, à des évaluations des ressources disponibles et à une véritable capacité de supervision locale.
La troisième piste est linguistique. Des outils mieux adaptés aux langues locales pourraient limiter certaines inefficacités de tokenisation. Mais cette amélioration ne doit pas être confondue avec une solution automatique à la dépendance matérielle : les deux problèmes sont liés par l'économie générale de l'IA, sans être techniquement équivalents.
Finalement, la question n'est pas de savoir si l'Afrique doit adopter l'intelligence artificielle. Elle l'utilise déjà dans un environnement numérique où les services financiers occupent une place considérable. La question est de déterminer à quelles conditions cette adoption peut renforcer son autonomie plutôt que créer de nouvelles dépendances.
Nous avons longtemps mesuré le progrès numérique au nombre de personnes connectées. Il faudra peut-être désormais le mesurer aussi à une capacité beaucoup moins spectaculaire : celle de refuser un service, de protéger ses ressources et d'appuyer soi-même sur le bouton d'arrêt.
Questions fréquentes
Pourquoi l'intelligence artificielle coûte-t-elle plus cher dans certaines langues ?
Les modèles découpent les textes en tokens, dont le nombre varie selon les langues. La Coalition for Language Equity in AI Research a observé des écarts allant jusqu'à dix-sept fois plus de tokens entre certaines langues, ce qui peut augmenter le coût des services facturés à l'utilisation.
Pourquoi les data centers consomment-ils autant d'eau et qui en paie le prix ?
Les serveurs et les processeurs spécialisés produisent beaucoup de chaleur et nécessitent des systèmes de refroidissement. Lorsque ceux-ci prélèvent de l'eau dans les ressources locales, les collectivités et les habitants peuvent subir une pression supplémentaire sur leur approvisionnement, particulièrement dans les régions exposées à la sécheresse.
Comment l'IA pourrait-elle menacer le mobile money en Afrique ?
Des agents IA disposant d'autorisations importantes pourraient provoquer des opérations non souhaitées, être compromis ou perturber des systèmes de paiement. Compte tenu du poids économique du mobile money en Afrique subsaharienne, la possibilité d'interrompre immédiatement ces agents représente un enjeu de sécurité majeur.
Existe-t-il des solutions locales pour réduire cette dépendance ?
Les modèles à poids ouverts, les infrastructures maîtrisées localement et les mécanismes d'arrêt d'urgence constituent des pistes concrètes. Aucun kill switch africain opérationnel n'est toutefois établi par les informations disponibles : sa conception, son intégration et sa gouvernance restent des défis à relever.
Sources
- Water consumption of African data centers in the age of AI (africa.engineering.cmu.edu)
- Big Tech’s thirst for water is sparking a global resistance (restofworld.org)
- Africa's data centers prompt water consumption fears (semafor.com)
- Why Africa needs its own AI off switch (restofworld.org)
- Africa Needs Its Own AI Shutdown Mechanism to Protect Critical ... (naijaeyesblog.com)
- AI models cost more when you don’t use English (restofworld.org)