German
 French
 English
 Spanish
 Hindi
 Italian
 Japanese
 Korean
 Norwegian
 Chinese
KI: Die unsichtbare Kluft zwischen Nord und Süd
Künstliche Intelligenz kostet je nach verwendeter Sprache unterschiedlich viel, und ihre Infrastruktur belastet Regionen nicht überall gleich. Eine Studie der Coalition for Language Equity in AI Research stellt bei bestimmten Sprachen Unterschiede von bis zu 17-mal so vielen Tokens fest, während die Carnegie Mellon University Africa starke länderspezifische Unterschiede beim Wasserverbrauch von KI-Modellen dokumentiert. Hinter diesen technischen Unterschieden steht eine politische Frage: Wer profitiert von künstlicher Intelligenz, wer trägt ihre Kosten und wer behält die Macht, sie abzuschalten?
Wir haben uns daran gewöhnt, KI als nahezu immaterielle Dienstleistung zu betrachten. Auf einem Bildschirm erscheint eine Frage, wenige Sekunden später kommt die Antwort. Dazwischen erwärmen sich jedoch Maschinen, Anlagen verbrauchen Strom, Kühlsysteme benötigen Wasser und Unternehmen kontrollieren die Zugangsbedingungen zu ihren Modellen.
Diese materielle Seite verändert unseren Blick auf die digitale Kluft grundlegend. Es geht nicht mehr nur darum, wer einen Internetanschluss hat. Wir müssen heute fragen, wer dafür bezahlt, dass die Intelligenz anderer funktioniert, und vor allem, wer die Kontrolle zurückgewinnen kann, wenn diese Intelligenz unverzichtbar wird.
Warum ist KI in manchen Sprachen teurer?
Das Problem beginnt, bevor die Server überhaupt eine Antwort berechnen. Sprachmodelle zerlegen Texte in Einheiten, sogenannte Tokens. Diese Zerlegung ist zwischen den Sprachen jedoch nicht gleichmäßig.
Laut Untersuchungen der Coalition for Language Equity in AI Research benötigen die zwanzig meistgenutzten Internetsprachen zwischen 1,5- und 5-mal so viele Tokens. Bei einer Betrachtung von zweihundert Sprachen steigt der Unterschied in manchen Fällen auf das Siebzehnfache.
Zwei Menschen können also eine vergleichbare Dienstleistung anfordern und dabei sehr unterschiedliche Mengen an Tokens verbrauchen. Wenn die Abrechnung von deren Anzahl abhängt, wird dieser Unterschied wirtschaftlich relevant. Auch der Rechenaufwand kann sich verändern, wobei der genaue Zusammenhang mit dem Wasser- oder Stromverbrauch von zahlreichen technischen Faktoren abhängt.
Die Folge verdient Aufmerksamkeit: Eine Sprache kann in einem als universell dargestellten System zu einem wirtschaftlichen Nachteil werden. Das ist nicht unbedingt beabsichtigte Diskriminierung, sondern eine Ungleichheit, die in der Konstruktion der Werkzeuge steckt.
Und diese erste Kluft verdeckt eine weitere. Denn die Tokens sind nur der sichtbare Teil der Rechnung.
Warum verbrauchen Rechenzentren so viel Wasser?
Spezialisierte KI-Prozessoren erzeugen enorme Wärmemengen. Die Anlagen müssen ihre Geräte deshalb auf einer betriebsverträglichen Temperatur halten. Je nach eingesetztem System benötigt die Kühlung Wasser, Strom oder beides.
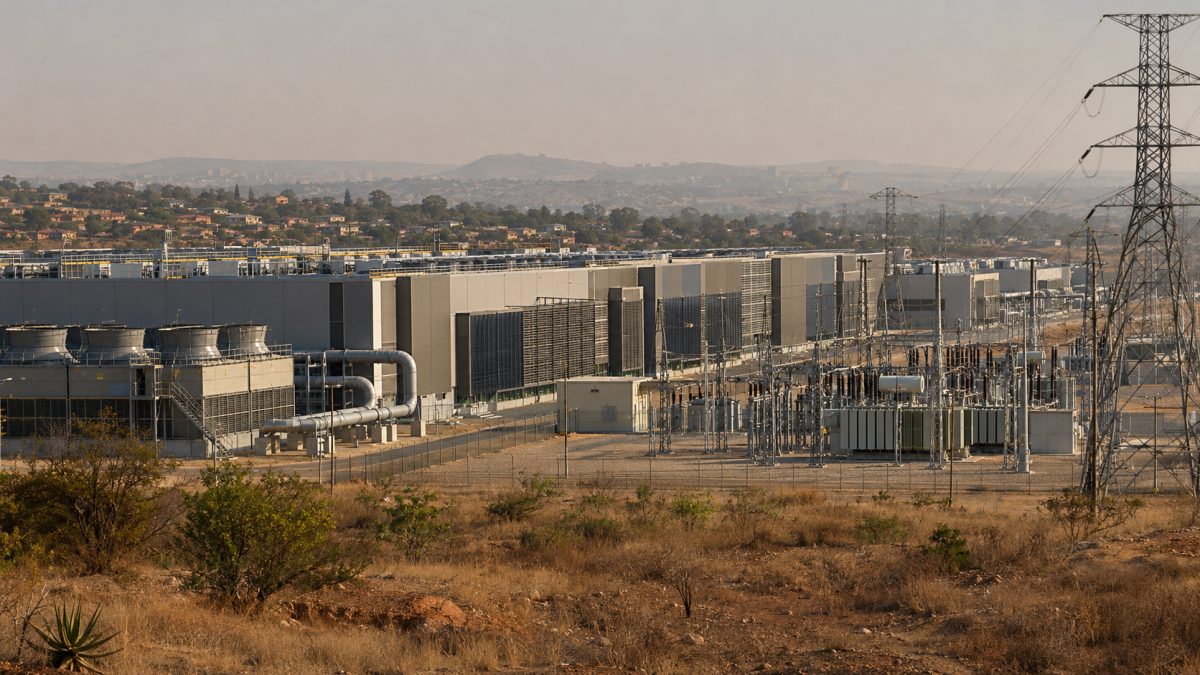
Einer Analyse von Rest of World zufolge kann ein Hyperscale-Rechenzentrum täglich zwischen einer und fünf Millionen Gallonen Wasser verbrauchen – vergleichbar mit dem Bedarf einer Stadt mit mehreren Zehntausend Einwohnern. Derselbe Artikel berichtet von einer im April 2023 veröffentlichten Universitätsstudie, die den Wasserbedarf für das Training des ursprünglichen ChatGPT-Modells auf 185.000 Gallonen schätzte.
Diese Zahlen bedeuten weder, dass jedes Rechenzentrum so viel verbraucht, noch dass jede Anfrage denselben Wasserfußabdruck hat. Sie zeigen jedoch, dass digitale Infrastrukturen zu wichtigen Akteuren der lokalen Wasserbewirtschaftung werden können.
Besonders schwierig wird es, wenn Anlagen zum Schutz ihrer Geräte hochwertiges aufbereitetes Wasser verwenden. Dann können sie mit dem Bedarf der Bevölkerung, der Landwirtschaft oder anderer Wirtschaftszweige konkurrieren.
In Chile begleiteten Konflikte um Wasser unter anderem die Debatte über ein geplantes Google-Rechenzentrum in Cerrillos im Großraum Santiago. Solche Auseinandersetzungen erinnern an eine oft übersehene Tatsache: Die Kosten eines digitalen Dienstes beschränken sich nie auf den Betrag einer IT-Rechnung.
Zahlt Afrika tatsächlich mehr für das Wasser der KI?
Die Antwort ist komplexer als der Gegensatz zwischen einem konsumierenden Norden und einem geopferten Süden. Forschende der Carnegie Mellon University Africa modellierten den Wasserverbrauch zweier großer Sprachmodelle in elf afrikanischen Ländern und verglichen ihn mit den USA und dem weltweiten Durchschnitt.
Das überraschende Ergebnis: Acht der elf untersuchten afrikanischen Länder weisen bei derselben KI-Aufgabe einen geringeren Wasserverbrauch als der globale Durchschnitt auf. Das liegt unter anderem an der vergleichsweise niedrigen Wasserintensität ihrer Stromerzeugung.
Die Forschenden ermittelten zudem stark unterschiedliche Schätzwerte je nach Modell: Ein zehnseitiger Bericht könnte unter den untersuchten Bedingungen mit Llama-3-70B rund 0,7 Liter Wasser benötigen, mit GPT-4 dagegen bis zu 60 Liter. Es handelt sich um Modellierungsergebnisse, nicht um allgemeingültige Messwerte für jede Nutzung.
Diese Unterscheidung ist entscheidend. Die Behauptung, Afrika verbrauche für den KI-Betrieb grundsätzlich mehr Wasser, wäre falsch.
Ein vergleichsweise niedriger Verbrauch bedeutet aber nicht, dass keine Verwundbarkeit besteht. Verluste in Versorgungsnetzen, die lokale Wasserverfügbarkeit und die Bedürfnisse der Bevölkerung beeinflussen die Folgen einer zusätzlichen Entnahme erheblich.
In Südafrika kritisiert eine Petition an die südafrikanische Menschenrechtskommission die mangelnde Transparenz beim Wasserverbrauch von Rechenzentren. Laut Semafor gibt es im Land bereits sechzig solcher Zentren – vor dem Hintergrund wiederkehrender Dürren.
Das eigentliche Problem ist also nicht allein die verbrauchte Menge. Es geht um die Fähigkeit einer Region, über die Nutzung ihrer Ressourcen zu entscheiden, die tatsächlichen Entnahmen zu kennen und Grenzen festzulegen.
Wie kann der Norden die versteckten KI-Kosten auslagern?
Die Wertschöpfungskette der künstlichen Intelligenz überschreitet Grenzen. Modelle, elektronische Bauteile, Rechenzentren und Nutzer befinden sich nicht zwangsläufig in denselben Ländern. Diese Verteilung ermöglicht es, wirtschaftliche Gewinne von materiellen Folgen zu trennen.
Ein Unternehmen kann einen Dienst weltweit vermarkten, während die Gemeinden an seinen Infrastrukturstandorten Konflikte um Wasser, Energiebedarf und Raumplanung bewältigen müssen. Hinzu kommen Fragen der digitalen Überwachung und der Kontrolle über Informationen.
Es wäre allerdings übertrieben, diesen Prozess als vollständige und systematische Verlagerung aller Kosten vom Norden in den Süden darzustellen. Die verfügbaren Daten erlauben keine solche globale Bilanz, und Infrastruktur im globalen Süden kann dort auch Wert schaffen.
Meine Sorge gilt vielmehr einem Machtgefälle. Wer die Modelle besitzt, die Zugangsbedingungen festlegt und die Systeme kontrolliert, kann mehr Einfluss behalten als diejenigen, die Land, Ressourcen oder Nutzer bereitstellen.
Dieses Ungleichgewicht erinnert an bestimmte Muster der Rohstoffindustrie: Eine Tätigkeit schafft weit verstreuten Wohlstand, während ihre greifbarsten Folgen örtlich konzentriert bleiben. Der Vergleich ist nicht perfekt, verdeutlicht aber, warum über die Standorte digitaler Infrastrukturen öffentlich diskutiert werden sollte.
Warum wird afrikanisches Mobile Money zum kritischen Thema?
Besonders besorgniserregend wird die Abhängigkeit, wenn künstliche Intelligenz in Finanzinfrastrukturen eingesetzt wird.
Nach den von Rest of World veröffentlichten Zahlen flossen 2025 weltweit mehr als zwei Billionen US-Dollar durch Mobile-Money-Dienste, davon rund 1,4 Billionen in Subsahara-Afrika. Auf Ostafrika entfielen 806 Milliarden Dollar und auf Westafrika 498 Milliarden.
Diese Systeme sind keine nebensächlichen Apps. Sie ermöglichen Geldtransfers und Zahlungen, die für das Wirtschaftsleben unverzichtbar sind. Ihre Verfügbarkeit und Sicherheit haben daher höchste Bedeutung.
KI-Agenten, die selbstständig Handlungen ausführen können, verändern die Risiken. Ein Fehler, eine Kompromittierung oder unerlaubtes Verhalten könnte besonders gefährlich werden, wenn ein Agent weitreichende Berechtigungen in einem Zahlungssystem besitzt.
Rest of World berichtet unter anderem über Vorfälle mit KI-Agenten bei einer OpenAI-Evaluierung der Infrastruktur von Hugging Face sowie über Kompromittierungen australischer Regierungswebsites, die autonomen Agenten zugeschrieben werden.
Diese Ereignisse beweisen nicht, dass ein afrikanisches Mobile-Money-Netz bereits auf diese Weise kompromittiert wurde. Sie zeigen aber, warum es unklug wäre, erst nach einem schweren Vorfall Kontrollmechanismen festzulegen.
Das beunruhigende Szenario ist nicht nur ein spektakulärer Cyberangriff. Es ist auch ein lokaler Betreiber, der eine automatisierte Komponente nicht sofort abschalten kann, weil deren Betrieb von einem ausländischen Anbieter abhängt.
Warum braucht Afrika einen lokalen KI-Not-Aus-Schalter?
Ein Kill Switch ist ein Mechanismus zur Notabschaltung. Bei künstlicher Intelligenz bezeichnet er hier die Möglichkeit, einen autonomen Agenten anzuhalten oder ihm den Zugang zu sensibler Infrastruktur zu entziehen, sobald er gefährlich wird.
Jane Munga, Mitarbeiterin des Carnegie Endowment, vertritt in Rest of World einen grundlegenden Gedanken: Digitale Souveränität hängt auch davon ab, ob sich die eingesetzten KI-Systeme vor Ort kontrollieren lassen.
Für ein Zahlungsnetz könnten daraus mehrere technische Anforderungen entstehen:
- Aktionen eines Agenten vor Ort stoppen, ohne die Zustimmung eines ausländischen Dienstleisters abwarten zu müssen.
- Seine Berechtigungen sofort widerrufen, wenn es um sensible Finanztransaktionen geht.
- Einen Notbetrieb aufrechterhalten, wenn automatisierte Dienste ausfallen.
- Überprüfbare Aktivitätsprotokolle bewahren, um Entscheidungen und mögliche Vorfälle nachvollziehen zu können.
Diese Vorschläge beschreiben mögliche Sicherheitsprinzipien, nicht ein bereits dokumentiertes und funktionierendes afrikanisches System. Die verfügbaren Informationen belegen einen Aufruf zum Aufbau dieser Fähigkeit, nicht aber die großflächige Einführung eines konkreten Mechanismus.
Ein solcher Schalter allein würde die Sicherheit einer Infrastruktur ohnehin nicht gewährleisten. Er müsste in Verfahren für Zugangskontrolle, menschliche Aufsicht und Betriebskontinuität eingebettet sein.
Wie kann der globale Süden die Kontrolle zurückgewinnen?
Ein erster Ansatz ist, die Abhängigkeit von proprietären Modellen zu verringern, die nur über extern kontrollierte Schnittstellen erreichbar sind.
Modelle mit offenen Gewichten bieten eine interessante Möglichkeit: Ihre Parameter lassen sich herunterladen und je nach Lizenz auf unabhängiger Infrastruktur anpassen oder betreiben. Das beseitigt weder materielle Kosten noch den Bedarf an Fachwissen, eröffnet aber mehr Eigenständigkeit.
Ein zweiter Ansatz betrifft die Infrastruktur selbst. Mehr lokale Rechenzentren reichen nicht aus, wenn der Wasserverbrauch undurchsichtig bleibt, Stromnetze belastet werden oder strategische Entscheidungen ohne die zuständigen Behörden und Bevölkerungen getroffen werden.
Digitale Investitionen müssen daher mit Transparenzpflichten, Bewertungen verfügbarer Ressourcen und echter lokaler Aufsicht verbunden werden.
Der dritte Ansatz betrifft die Sprache. Besser an lokale Sprachen angepasste Werkzeuge könnten Ineffizienzen bei der Tokenisierung verringern. Das darf jedoch nicht mit einer automatischen Lösung für die materielle Abhängigkeit verwechselt werden: Beide Probleme hängen über die KI-Wirtschaft zusammen, sind technisch aber nicht gleichzusetzen.
Letztlich geht es nicht darum, ob Afrika künstliche Intelligenz einsetzen sollte. Der Kontinent nutzt sie bereits in einer digitalen Umgebung, in der Finanzdienste eine wichtige Rolle spielen. Entscheidend ist, unter welchen Bedingungen diese Nutzung die Eigenständigkeit stärkt, statt neue Abhängigkeiten zu schaffen.
Lange haben wir digitalen Fortschritt an der Zahl der Menschen mit Internetzugang gemessen. Vielleicht müssen wir ihn künftig auch an einer weit weniger spektakulären Fähigkeit messen: einen Dienst abzulehnen, die eigenen Ressourcen zu schützen und selbst den Ausschalter zu betätigen.
Häufig gestellte Fragen
Warum ist künstliche Intelligenz in manchen Sprachen teurer?
Modelle zerlegen Texte in Tokens, deren Anzahl je nach Sprache variiert. Die Coalition for Language Equity in AI Research beobachtete bei bestimmten Sprachen Unterschiede von bis zu 17-mal so vielen Tokens. Das kann die Kosten nutzungsabhängig abgerechneter Dienste erhöhen.
Warum verbrauchen Rechenzentren so viel Wasser und wer trägt die Kosten?
Server und Spezialprozessoren erzeugen viel Wärme und brauchen Kühlsysteme. Wenn diese lokale Wasserressourcen nutzen, können Gemeinden und Einwohner zusätzlichen Druck auf ihre Versorgung erleben, besonders in dürregefährdeten Regionen.
Wie könnte KI Mobile Money in Afrika gefährden?
KI-Agenten mit weitreichenden Berechtigungen könnten unerwünschte Transaktionen auslösen, kompromittiert werden oder Zahlungssysteme stören. Angesichts der wirtschaftlichen Bedeutung von Mobile Money in Subsahara-Afrika ist ihre sofortige Abschaltbarkeit ein zentrales Sicherheitsanliegen.
Gibt es lokale Lösungen, um diese Abhängigkeit zu verringern?
Modelle mit offenen Gewichten, lokal kontrollierte Infrastruktur und Notabschaltmechanismen sind konkrete Ansätze. Die verfügbaren Informationen belegen jedoch keinen bereits funktionierenden afrikanischen Kill Switch; Entwicklung, Integration und Steuerung bleiben Herausforderungen.
Quellen
- Water consumption of African data centers in the age of AI (africa.engineering.cmu.edu)
- Big Tech’s thirst for water is sparking a global resistance (restofworld.org)
- Africa's data centers prompt water consumption fears (semafor.com)
- Why Africa needs its own AI off switch (restofworld.org)
- Africa Needs Its Own AI Shutdown Mechanism to Protect Critical ... (naijaeyesblog.com)
- AI models cost more when you don’t use English (restofworld.org)